EXTRACTO DEL LIBRO · Parte II · Cómo las máquinas se volvieron inteligentes
Tres avances que se reforzaron entre sí
Descargar este extracto en PDF ↓
El PDF conserva el idioma inglés del documento original.
Las ilustraciones y las cubiertas conservan su texto original en inglés.
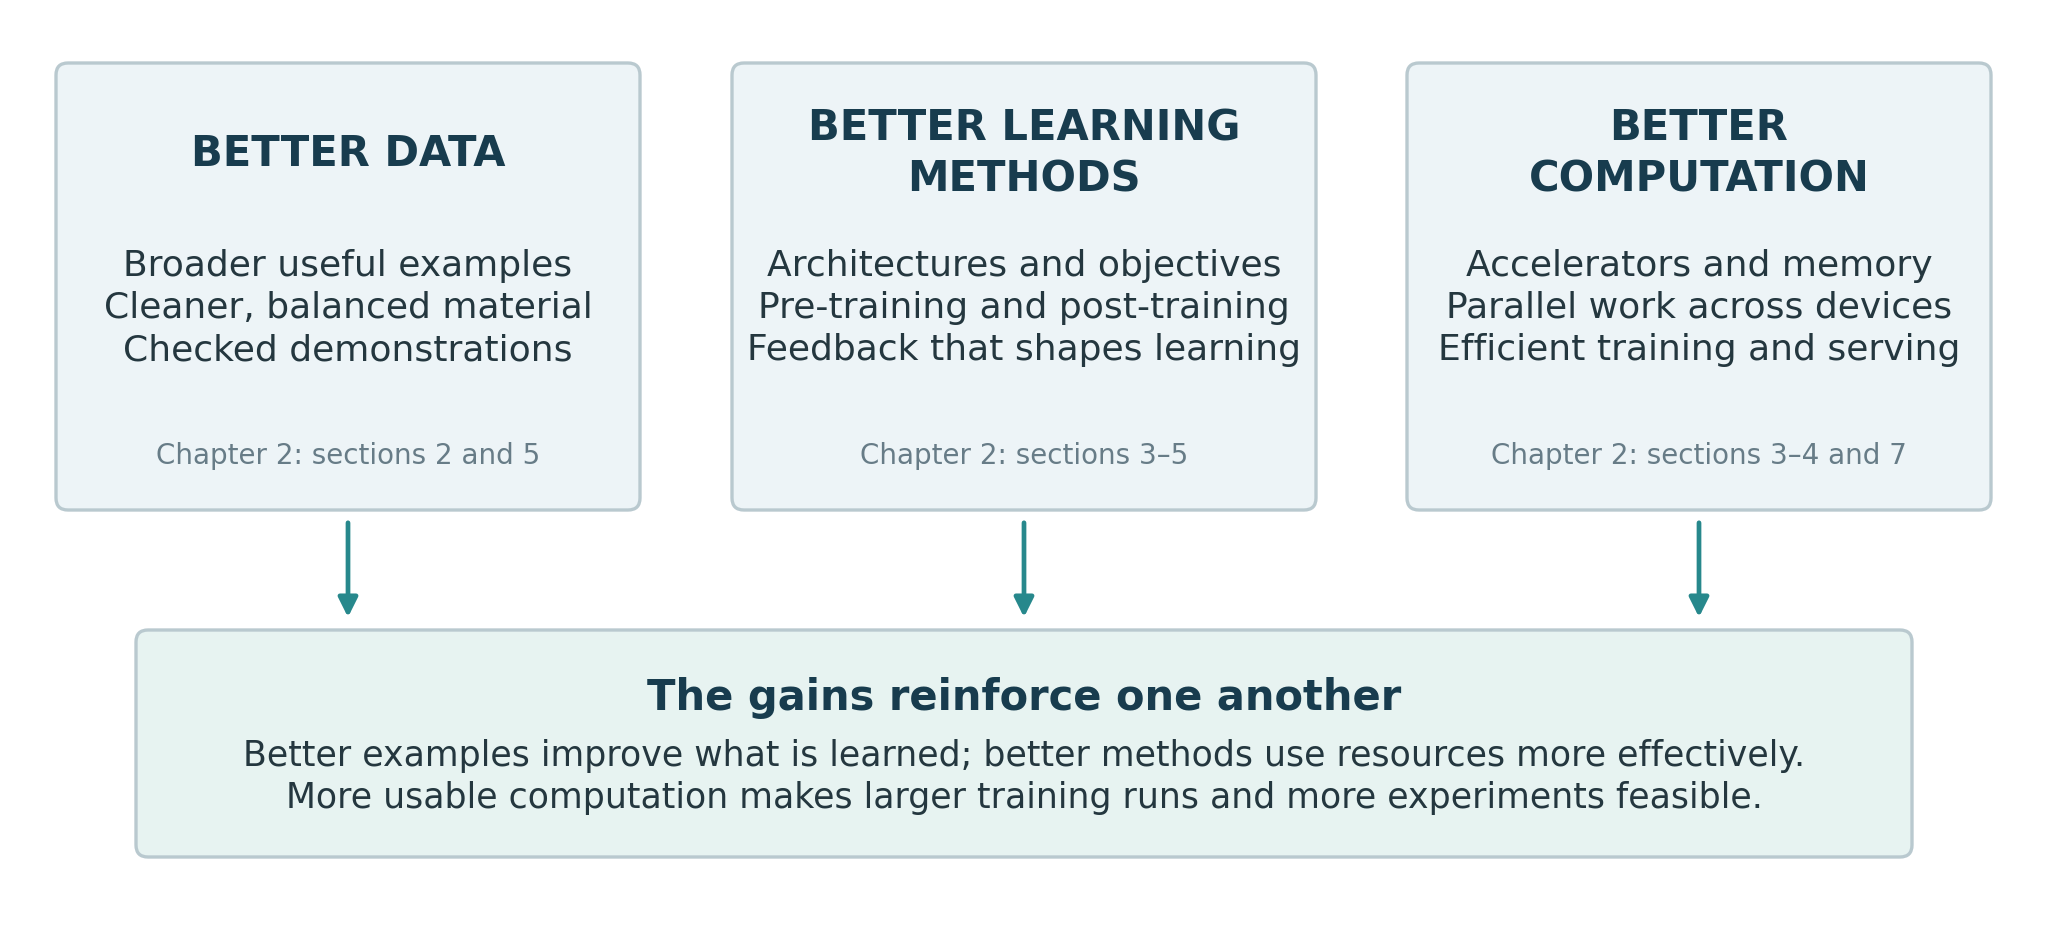
Figura II.2 Tres motores interrelacionados de las capacidades de las máquinas. Los datos determinan los ejemplos disponibles; los métodos de aprendizaje determinan cómo la experiencia modifica el modelo; los recursos de cómputo determinan qué puede realizarse a una escala viable. Es un marco conceptual, no una distribución medida del progreso. Las referencias a secciones remiten al capítulo 2 de la parte II. [II.2, II.5–II.7]
Mejores datos
La oferta de texto digital, código y otros materiales amplió aquello con lo que las máquinas podían entrar en contacto. La mejora también vino de seleccionar ese material con más cuidado: recuperar correctamente una tabla, eliminar páginas repetidas, equilibrar idiomas y comprobar demostraciones. FineWeb muestra por qué la preparación merece atención junto con el volumen. Para el lector que construye un modelo, la pregunta es qué enseña cada ejemplo. En el capítulo 2, la sección 2 sigue ese trabajo; la sección 5 vuelve a los datos diseñados para enseñar a un asistente a responder. [II.5, II.6]
Mejores métodos de aprendizaje
Nuevas arquitecturas y objetivos de entrenamiento permitieron aprovechar mejor esos ejemplos. El Transformer cambió la forma en que un modelo relaciona posiciones dentro de una secuencia y facilitó paralelizar el entrenamiento. Después, el preentrenamiento general, los ejemplos de instrucciones y la retroalimentación aportaron distintos tipos de señales de aprendizaje. Son avances diferentes en cómo se construye y se enseña a un modelo. Las secciones 3–5 del capítulo 2 los explican, incluido por qué la mezcla de expertos es una elección arquitectónica y el aprendizaje de preferencias es un método de entrenamiento. [II.2, II.8–II.10]
Mejores recursos de cómputo
Los aceleradores, la memoria, las conexiones rápidas entre dispositivos y un mejor software hicieron viables experimentos mayores. El progreso incluye utilizar el hardware disponible con más eficacia, además de añadir más. El equilibrio importa: los experimentos Chinchilla mostraron que cambiar el reparto de un presupuesto de cómputo fijo entre el tamaño del modelo y los datos de entrenamiento podía mejorar los resultados. En el capítulo 2, las secciones 3–4 explican las limitaciones del entrenamiento; la sección 7 sigue el coste de ofrecer respuestas. [II.6, II.7, II.24]
Las fronteras se solapan. Un método de aprendizaje eficiente puede reducir el cómputo necesario, mientras que más recursos de cómputo pueden permitir una mezcla distinta de datos o un experimento mayor. Ninguno de estos motores garantiza por sí solo una respuesta fiable. La evaluación y la supervisión determinan si una mayor capacidad resulta útil en el contexto previsto. La secuencia histórica muestra cómo estos tres avances terminan confluyendo en la construcción de un modelo.